목차
- 글을 시작하며
- 문제는 "통신"이 아니라 "장기 실행 상태를 어떻게 유지할 것인가"였다
- 단순 구현만으로는 왜 운영이 어려워지는가
- 왜 이 문제를 구조적으로 풀어야 했는가
- 설계 목표
- 선택한 구조
- 상태와 실패를 어떻게 봤는가
- 왜 운영 안정성에 유리한가
- 이 프로젝트를 통해 다시 확인한 점
- 마무리
실서비스를 운영하다 보면 모든 작업이 요청-응답 기반 API로만 해결되지는 않는다.
외부 시스템과 지속적으로 연결을 유지하거나, 특정 이벤트를 오래 기다리거나, 장애 이후에도 다시 복구되어야 하는 작업은 종종 장기 실행 프로세스(Long-Running Process) 형태로 운영된다.
특히 Socket, HTTP/HTTPS, SMTP, FCM처럼 여러 통신 채널을 다루는 Daemon은
단순히 "통신이 된다"는 것만으로 충분하지 않다.
실제 운영 환경에서는 아래와 같은 문제가 더 중요해진다.
- 특정 구간의 순차 처리로 인해 응답 지연이 누적될 수 있다
- 연결 실패나 일시 장애 이후 복구 전략이 없으면 작업이 멈출 수 있다
- 설정값이 하드코딩되어 있으면 운영 중 변경 대응이 비효율적이다
- 실패한 요청을 어떻게 재시도할지 기준이 없으면 장애가 길어진다
- 로그와 상태가 정리되지 않으면 문제 원인 파악이 어려워진다
이번 글에서는 이런 문제를 단순 Socket 통신 구현이 아니라
운영 환경에서 장기 실행 Daemon을 안정적으로 유지하기 위한 구조 문제로 보고,
java-socket-daemon-springboot 프로젝트를 통해 어떤 기준으로 설계했는지 정리해보려 한다.
Repository:
java-socket-daemon-springboot
1. 문제는 "통신"이 아니라 "장기 실행 상태를 어떻게 유지할 것인가"였다
처음에는 외부 연동 Daemon을
"연결하고, 요청 보내고, 응답 받으면 끝나는 프로그램"처럼 생각하기 쉽다.
하지만 운영 환경에서 Daemon은 한 번 실행되고 끝나는 배치와 다르다.
오랫동안 살아 있어야 하고, 실패해도 다시 복구되어야 하며,
순간적인 트래픽 증가에도 전체 흐름이 무너지지 않아야 한다.
특히 레거시 Pure Java 기반 Daemon에서는 아래 같은 문제가 쉽게 드러난다.
- 요청을 순차적으로 처리해 병목이 생긴다
- 특정 외부 연동 구간이 지연되면 전체 작업이 대기한다
- 연동사별 IP, Port, 설정값이 코드에 하드코딩되어 있다
- 운영 중 설정 변경이 필요해도 재배포가 필요하다
- 장애 발생 시 어느 단계에서 막혔는지 추적하기 어렵다
즉 문제의 본질은
"Socket 통신을 구현할 수 있는가"가 아니라
"장기 실행되는 프로세스를 운영 환경에서도 안정적으로 유지할 수 있는가"에 있었다.
2. 단순 구현만으로는 왜 운영이 어려워지는가
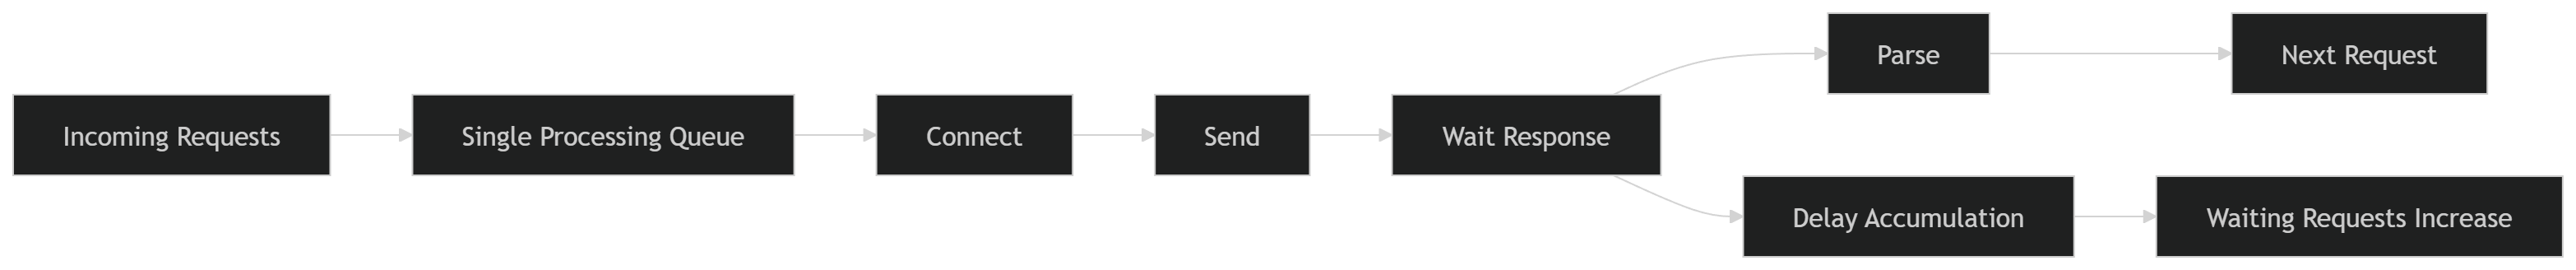
초기 구현은 보통 아래 흐름으로 시작한다.
- 외부 시스템과 Socket 연결을 맺는다
- 요청을 보낸다
- 응답을 기다린다
- 결과를 파싱한다
- 다음 요청을 처리한다
기능적으로는 동작한다.
하지만 장기 실행 프로세스는 시간이 길어질수록 운영 문제가 구조 문제로 바뀐다.
1) 순차 처리 병목이 전체 지연으로 이어질 수 있다
특정 요청이 오래 걸리면 뒤에 대기 중인 작업들도 함께 밀린다.
이 구조는 트래픽 집중 시 처리량보다 대기 시간이 더 빠르게 늘어나는 문제가 생긴다.
2) 장애 이후 복구 기준이 없으면 프로세스가 멈춘다
일시적인 연결 실패나 Timeout은 언제든 발생할 수 있다.
이때 재연결, 재시도, Skip 기준이 없으면 Daemon은 "실패한 채 멈춘 프로세스"가 되기 쉽다.
3) 설정값 하드코딩은 운영 비용을 높인다
연동사별 IP, Port, Timeout, 재시도 횟수 같은 값이 코드에 박혀 있으면
운영 중 환경 변경 시 수정-빌드-배포가 반복된다.
4) 로그가 없으면 장기 실행 프로세스는 블랙박스가 된다
운영에서는 "안 된다"보다
언제, 어떤 요청이, 어느 구간에서, 왜 실패했는지를 알아야 한다.
결국 Daemon은 단순 통신 프로그램이 아니라
장기 실행, 장애 복구, 설정 관리, 처리량 유지까지 포함한 운영 구조로 설계해야 했다.
3. 왜 이 문제를 구조적으로 풀어야 했는가
이 문제를 볼 때 중요하게 본 건 "통신 기능을 구현한다"가 아니라,
운영 중에도 오래 버티는 프로세스를 만드는 것이었다.
핵심은 네 가지였다.
1) 병목이 생겨도 전체가 같이 멈추지 않아야 한다
장기 실행 프로세스는 한 요청의 지연이 전체 시스템 지연으로 번지지 않도록
처리 구조 자체를 분리할 필요가 있었다.
2) 실패는 복구 가능한 실패와 아닌 실패를 나눠서 봐야 한다
모든 실패를 같은 실패로 보면 안 된다.
- 일시적인 네트워크 장애
- Socket 연결 실패
- 외부 응답 지연
- 잘못된 요청 데이터
- 파싱 불가 응답
- 정책상 재시도 불필요한 실패
이 구분이 있어야 재시도와 운영 대응 기준이 명확해진다.
3) 설정은 코드가 아니라 운영 가능한 방식으로 관리되어야 한다
장기 실행 프로세스는 운영 중 설정 변경 수요가 자주 생긴다.
그래서 IP, Port, Timeout, 스레드 수 같은 값은 코드 수정 없이 다룰 수 있어야 했다.
4) 상태와 로그가 보여야 운영이 가능하다
Daemon은 요청-응답이 눈앞에서 끝나는 API와 다르기 때문에,
로그와 상태 관리가 없으면 장애 원인 파악이 훨씬 어렵다.
그래서 이 프로젝트는 단순한 통신 구현이 아니라
장기 실행 Daemon을 운영 가능한 구조로 만드는 것에 초점을 맞췄다.
4. 설계 목표
이 프로젝트를 설계하면서 잡은 목표는 아래와 같았다.
1) 순차 처리 병목을 줄일 것
트래픽이 몰릴 때도 전체 대기 시간이 과도하게 증가하지 않도록
비동기 처리 구조를 도입하고 싶었다.
2) 장애 이후 복구 가능한 구조를 만들 것
연결 실패, Timeout, 일시 장애가 발생해도
프로세스 전체가 쉽게 멈추지 않도록 재시도와 복구 기준을 두고 싶었다.
3) 설정값을 운영 중에도 유연하게 다룰 것
연동사 정보와 주요 설정값을 외부화해
재배포 없이 변경 가능한 구조를 만들고 싶었다.
4) 상태 추적과 운영 로그를 명확히 남길 것
어떤 요청이 언제 들어왔고, 어느 단계에서 처리되었고,
실패했다면 왜 실패했는지 남길 수 있어야 했다.
결국 핵심은
"통신이 된다"가 아니라
"오래 실행되어도 운영 가능한 구조인가"였다.
5. 선택한 구조
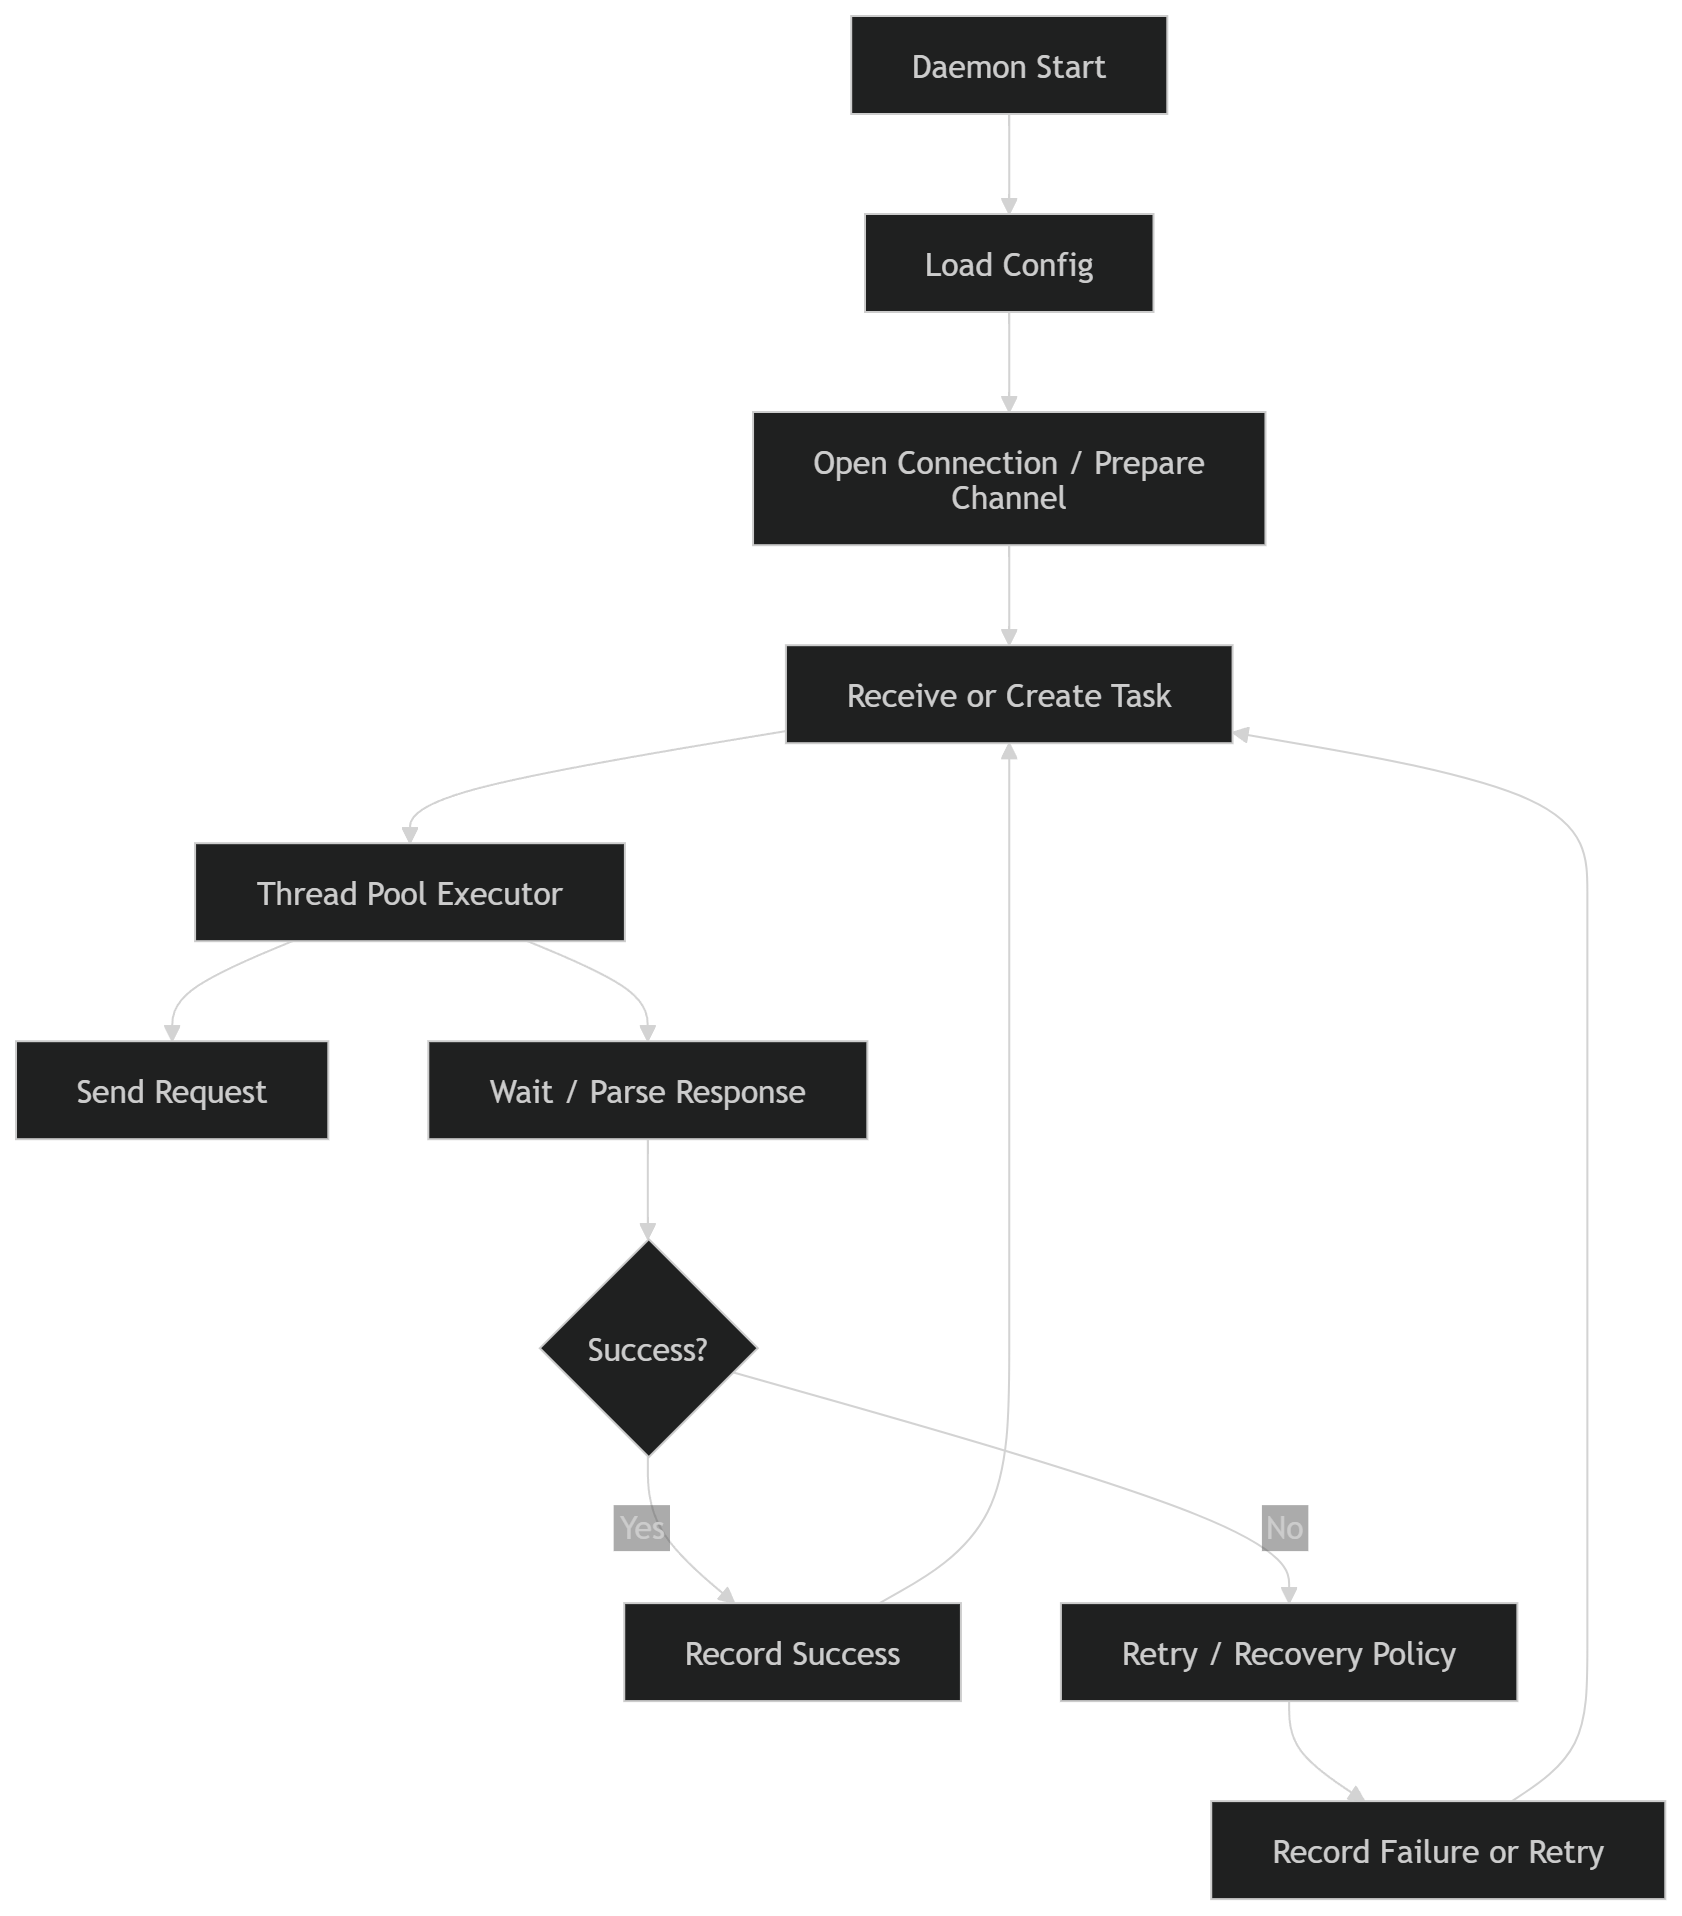
이 프로젝트에서는 Daemon을 아래 흐름으로 나눠서 봤다.
- Daemon Lifecycle: 시작, 실행, 종료, 복구
- Connection Layer: 외부 시스템 연결 관리
- Async Processing Layer: 비동기 처리 및 병렬 실행
- Retry / Recovery Policy: 재시도와 복구 기준 관리
- Config Manager: 설정 외부화 및 반영
- Logging / Monitoring Point: 상태 추적과 운영 로그
핵심은 단순 통신 로직에 모든 책임을 몰아넣지 않고,
실행 구조, 복구 구조, 설정 구조를 분리한 점이다.
Lifecycle를 별도로 봤다
Daemon은 한 번 실행한 뒤 끝나는 프로그램이 아니기 때문에
시작 → 실행 → 장애 → 복구 → 종료 흐름을 별도 관점으로 봐야 했다.
즉, 비즈니스 처리 로직만 보는 것이 아니라
프로세스 자체가 오래 살아남을 수 있는가를 함께 고려했다.
비동기 처리 구조를 도입했다
기존 순차 처리 구조에서는 한 요청의 지연이 전체 대기열 지연으로 이어질 수 있었다.
그래서 Thread Pool 기반 비동기 처리 구조를 적용해
병렬로 처리 가능한 요청은 분산 처리할 수 있도록 설계했다.
이 구조의 목적은 단순 성능 향상보다
지연 전파를 완화하고 처리 흐름을 분리하는 것에 있었다.
Retry는 단순 반복이 아니라 정책이어야 했다
일시 장애는 재시도 의미가 있지만,
잘못된 요청 데이터나 구조적 오류는 반복해도 해결되지 않는다.
그래서 Retry는 "실패하면 다시 한 번"이 아니라
실패 원인에 따라 다르게 적용되는 운영 정책으로 봤다.
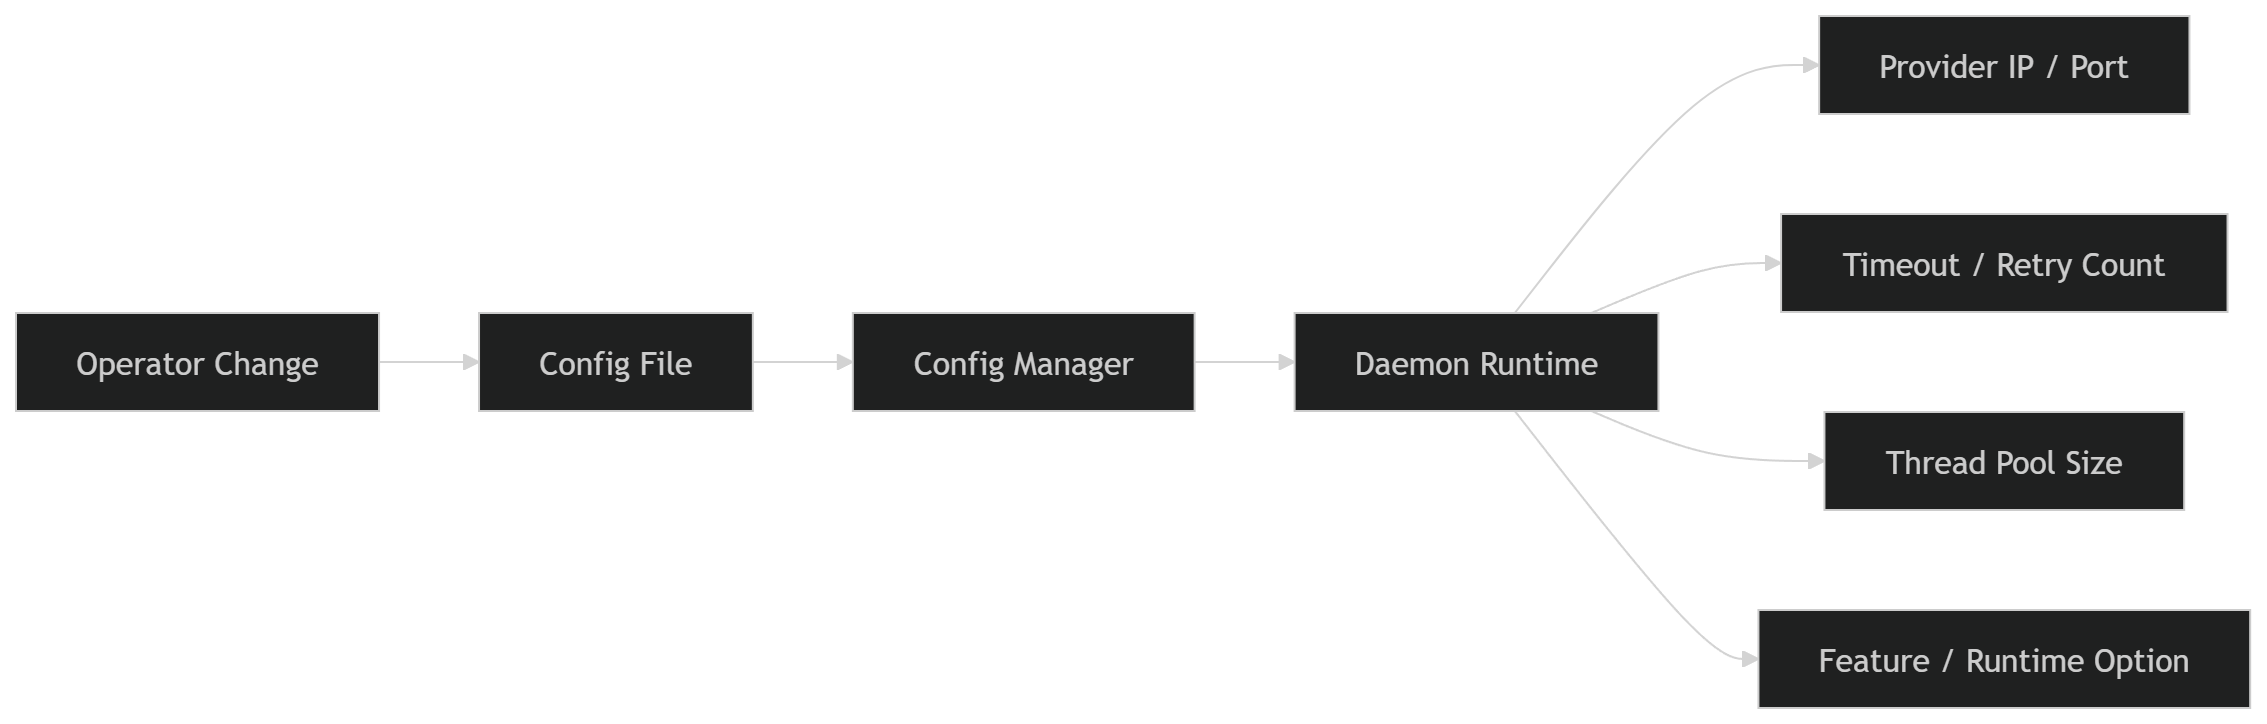
Config Manager를 둬서 설정을 외부화했다
장기 실행 Daemon은 운영 중 설정 변경이 빈번할 수 있다.
연동사별 IP, Port, Timeout, 재시도 횟수 같은 값이 하드코딩되어 있으면 운영 비용이 커진다.
그래서 Config Manager를 두고
설정 파일을 통해 주요 값을 관리할 수 있게 구성했다.
6. 상태와 실패를 어떻게 봤는가
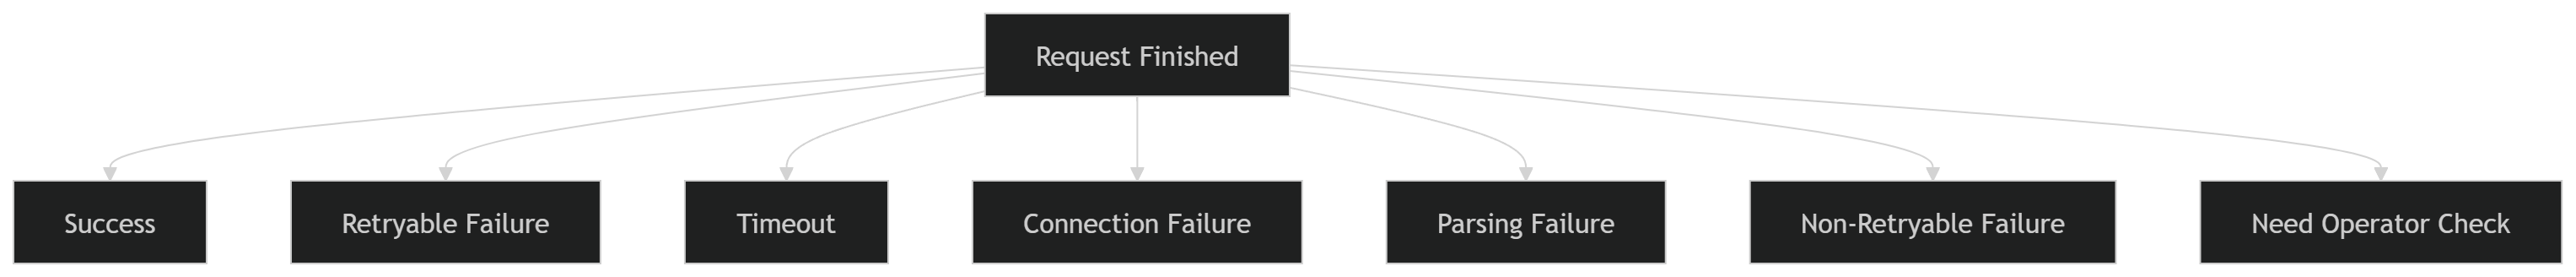
장기 실행 Daemon에서는 성공/실패 이분법만으로는 운영이 어렵다.
어떤 상태로 실패했고, 그 실패가 복구 가능한지까지 함께 봐야 한다.
예를 들면 아래처럼 나눠서 볼 수 있다.
- 정상 처리 완료
- 일시 장애로 인한 재시도 대상
- Timeout 발생
- 연결 실패
- 파싱 실패
- 재시도 불필요한 실패
- 운영자 확인이 필요한 실패
이처럼 결과 상태를 세분화해야 운영자가 "재시도 대상인지, 수동 확인 대상인지, 구조적 오류인지"를 빠르게 판단할 수 있다.
일시 장애와 구조적 실패는 다르다
네트워크 단절, 응답 지연, 외부 시스템 순간 장애는
조건에 따라 재시도가 의미가 있다.
반면 잘못된 요청 데이터, 파싱 불가 응답, 계약상 잘못된 포맷은
같은 방식의 반복 처리만으로 해결되지 않을 수 있다.
응답 지연은 성능 문제이면서 운영 문제다
Daemon에서는 응답 지연이 단순 느림으로 끝나지 않는다.
대기 요청 누적, 스레드 점유, 후속 작업 지연으로 이어질 수 있기 때문이다.
그래서 Timeout과 지연 누적을
성능 이슈가 아니라 운영 안정성 이슈로 봤다.
로그는 요청 단위와 상태 단위로 남겨야 했다
장기 실행 프로세스는 시간이 길고 단계가 많기 때문에
"실패했다" 한 줄로는 운영이 불가능하다.
어떤 요청이 들어왔고,
어느 채널로 전송되었고,
몇 번 재시도했으며,
최종적으로 어떤 상태로 끝났는지가 보여야 했다.
7. 왜 운영 안정성에 유리한가
이 구조의 장점은 단순히 Daemon이 돌아간다는 데 있지 않다.
실제 운영에서 문제를 덜 만들고, 생긴 문제를 더 빨리 해석할 수 있다는 데 있다.
1) 병목 전파를 줄일 수 있다
비동기 처리 구조를 통해
한 요청의 지연이 전체 처리 흐름을 막는 문제를 완화할 수 있다.
2) 장애 이후에도 전체 프로세스가 쉽게 무너지지 않는다
재시도와 복구 기준을 두면
일시적인 장애가 곧 전체 중단으로 이어지는 상황을 줄일 수 있다.
3) 설정 변경 대응이 빨라진다
운영 중 변경이 필요한 값을 외부화하면
재배포 의존도를 줄이고 대응 속도를 높일 수 있다.
4) 운영 추적과 장애 분석이 쉬워진다
요청 흐름, 실패 상태, 재시도 여부, 설정값 영향을 나눠서 볼 수 있기 때문에
문제 원인을 훨씬 빠르게 좁힐 수 있다.
8. 이 프로젝트를 통해 다시 확인한 점
장기 실행 Daemon은 단순히 "계속 켜져 있는 프로그램"이 아니다.
오히려 더 중요한 건 아래에 가깝다.
- 오래 실행되어도 병목이 누적되지 않는가
- 일시 장애 이후 복구 기준이 있는가
- 설정 변경을 운영 친화적으로 반영할 수 있는가
- 요청 상태와 실패 원인을 추적할 수 있는가
결국 Daemon도 운영 시스템의 일부이기 때문에
기능 구현보다 장기 실행 안정성, 복구 가능성, 운영 편의성이 더 중요해지는 순간이 많다.
java-socket-daemon-springboot는 그런 관점에서
단순 Socket 통신 구현이 아니라,
레거시 Pure Java 기반 장기 실행 Daemon을 Spring Boot/Gradle 기반 구조로 재정비하고
비동기 처리, 재시도 정책, 설정 외부화, 운영 추적성을 강화하는 방향으로 설계한 프로젝트다.
9. 마무리
이 글은 단순히 기능을 구현한 경험을 설명하기보다,
운영 환경에서 실제로 문제가 되는 지점을 어떤 구조로 풀어냈는지를 정리하기 위해 작성했습니다.
- GitHub:
github.com/Gseobi - Portfolio:
github.com/Gseobi/portfolio - Repository:
java-socket-daemon-springboot
전체 포트폴리오 글은 여기서 한 번에 볼 수 있습니다.
[백엔드 포트폴리오 글 모음]
